なか2656のblog

とある会社の社員が、法律などをできるだけわかりやすく書いたブログです

タグ:AI

PCとAI

1.はじめに
米カリフォルニア州の、モブリー対ワークデイ訴訟(Mobley v. Workday 訴訟)は、AIを利用した採用ツールが違法・不当に求職者を選別・差別しているかを争点とした集団訴訟という点で注目を集めています。以下少し調べてみました。本訴訟は現在係争中のものですが、以下のとおり注目すべき内容を含んでいます。

2.モブリー対ワークデイ訴訟の事案の概要と裁判所の判断
(1)事件番号等

事件番号:3:23-cv-00770
管轄裁判所: 米国カリフォルニア州北部地区連邦地方裁判所 (U.S. District Court for the Northern District of California)
提訴日: 2023年2月21日
訴訟の種類: 442 公民権(雇用・就業差別) (Civil Rights: Jobs)

(2)事案の概要
原告の一人の、デレク・モブレー氏(Derek Mobley)は、50歳代でITエンジニア、うつ病などの精神疾患をもつ求職者であったが、2018年以降に100件を超える採用選考に応募し、いずれも不採用となった。そこで、クラウド型HRソフトウェア大手のワークデイ社(Workday社)に対し、同社のAI搭載採用ツールが、人種・年齢・性別・障害といった属性を理由に求職者を不当に選別・差別しているとして、2023年2月21日に訴訟を提起したものです。

原告らは人種・年齢を理由とする意図的差別、および人種・年齢・障害を理由とする差別的効果(disparate impact)について、1964年公民権法第7章(人種・皮膚の色などを理由とした従業員の差別を禁止する規定)、1866年公民権法(Section 1981)、ADEA(年齢差別禁止法)、ADA(障害者差別禁止法)に基づく請求を主張し、さらにワークデイ社による差別の幇助(aiding and abetting)についてカリフォルニア州公正雇用住宅法(FEHA)に基づく請求も行っています。

北カリフォルニア連邦地裁のRita F. Lin判事がこの案件を担当しており、訴訟は複数回の訴状修正と却下申立てを経て進行してきました。

(3)裁判所の判断の経緯
(ア)2024年7月(最初の実質判断)の裁判所の判断
裁判官は、ワークデイ社の却下を求める申立てを一部認容・一部棄却しました。この際、AIベンダーであるワークデイ社が、雇用主の「代理人(agent)」として差別責任を問われ得るとの判断が示され、AIを用いた採用支援サービスを提供するベンダーも差別訴訟の被告になり得ることを示す画期的な先例として注目されました。

(イ)2026年6月22日(最新の判断)
裁判官は、原告らの第4次修正訴状(Fourth/Third Amended Complaint)に対するワークデイ社の却下申立てについて、再び大部分を棄却(=原告の請求の存続を認める)する決定を下しました。主なポイントは以下の通りです。

(a)カリフォルニア州法(FEHA)の適用範囲
ワークデイ社は、「自社のツールはカリフォルニア州外の求職者に適用されたものであり、FEHA(カリフォルニア州公正雇用住宅法)は適用されない」と主張しましたが、裁判所はこれを退けました。ワークデイ社がカリフォルニア州の本社で本件ツールを設計・開発・運用しているという原告の主張により、カリフォルニア州との十分な関連性(nexus)が認められると裁判所は判断しました。差別的な運用の起点がカリフォルニア州内の事業活動にあると認められる限り、応募者や採用先の所在地が州外であってもFEHAが適用され得るとの判断です。

(b)ADA(障害者差別法)に基づく請求
原告の一人が新たに追加した「代理指標(proxy)による差別」の主張については、これは以前に裁判所が修正を認めた範囲内のものであるとして、裁判所は、ワークデイ社の却下を求める申立てを退けました。具体的には、医療目的の休職による職歴の空白期間など、障害を推知させる代理指標に基づいてAIが応募者を排除している可能性があるという原告らの主張について、裁判所はこれを却下しませんでした。

(4)本件訴訟の意義
この訴訟は、AI採用ツールを提供するベンダー自体が差別訴訟の被告となり得ること、および州境を越えて用いられるAIツールであっても、開発・運用拠点の所在地(カリフォルニア州)を根拠に州法の適用を受け得ることを示した点で重要とされています。この段階の決定はワークデイ社の技術が実際に差別的であるかどうかの結論を示すものではありませんが、原告が証拠開示(ディスカバリー)手続きを通じて主張を追及することを認めるものであり、AI採用ツールに対する社会の監視の高まりを改めて示すものとなっています。

(5)補足:「代理指標(proxy)による差別」とは何か
ADA(障害者差別法)は、雇用主が求職者の障害を理由に不採用とすることを禁じていますが、実務上、雇用主(やAIツール)が「障害」そのものを直接の判断材料にしなくても、障害と統計的に相関する別の情報(=代理指標、proxy)を使って間接的に障害者を排除している場合、それもADA違反となり得るという考え方が、「代理指標(proxy)による差別」です。

原告らは、本件訴訟において、ワークデイ社の採用AIソフトウェアが、医療目的の休職に起因する職歴の空白期間や、治療・療養を経た者に典型的に見られるパターンといった情報を手がかりに、障害を持つ応募者を不当に排除している可能性がある、と主張しています。 つまり、職歴データに「〇年間のブランク」がある、そのブランクのパターンが、病気治療・入院・リハビリなどでキャリアが中断した人によく見られる形をしている、といった情報をAIスクリーニングツールが(意図的か否かにかかわらず)拾い上げ、これを「望ましくない候補者」のシグナルとして扱っている結果、障害を持つ応募者が不当に足切りされているのではないか、という主張です。

障害の診断名や病歴そのものを直接尋ねているわけではなくても、統計的に障害と強く結びつく別のデータ(職歴の空白パターンなど)を用いることで、実質的に障害者を狙い撃ちにした選別と同じ効果が生じ得る、というのがこの「proxy discrimination(代理指標による差別)」理論の概要です。

3.まとめ
このように、モブリー対ワークデイ訴訟において、原告らは、ワークデイ社のアルゴリズムが職歴の空白などを理由に、黒人や高齢者、障害者を自動的に弾いていると主張しています。そのため、AIがどのような基準で人を不採用にしたのか、そのアルゴリズムの開示を求める本格的な裁判となっており、この点が注目されています。

また、本件訴訟は、裁判所が、AIツールを提供するワークデイ社を雇用差別法上の「間接的な雇用主(雇用の仲介者)」とみなす余地を認めたため、IT企業側が直面する法的リスクが大きく増加する可能性があります。すなわち、外部AIベンダーも「雇用主」として採用差別について責任を負うとの判決が出される可能性があり、注目されています。

最近の日本においても、多くの企業が採用選考にAIツールを利用していると考えられますが、日本の企業の人事労務部門や法務部門、IT部門なども、このモブリー対ワークデイ訴訟においてどのような判決が出されるか注目すべきように思われます。

このブログ記事が参考になった・面白かったという方は、ぜひSNSでシェアや「いいね」をお願いいたします!!

■関連するブログ記事
・キリンが新卒採用に「AI面接官」を試験導入することを個情法・労働法から考えた
・就活のSNSの「裏アカ」の調査や、ウェブ面接での「部屋着を見せて」等の要求などを労働法・個人情報保護法から考えた(追記あり)
・コロナ下のテレワーク等におけるPCなどを利用した従業員のモニタリング・監視を考えた(追記あり)


■参考文献
・「超知能 きしむ世界(3)「アルゴリズムが差別」訴訟に発展 採用にAI、問われる責任」|日本経済新聞
・California Federal Court Grants In Part And Denies In Part Workday’s Motion To Dismiss In Mobley v. Workday|CLASS ACTION DEFENSE
・Recent Developments in Mobley v. Workday: California Court Allows Key AI-Hiring Bias Claims to Move Forward|REAVIS PAGE JUMP

人気ブログランキング

ブログランキング・にほんブログ村へ

このエントリーをはてなブックマークに追加 mixiチェック

1.はじめに
2026年7月10日、このブログでも取り上げていた改正個人情報保護法が国会で可決・成立しました。国会審議で大きな争点となったのは、「統計特例」です。すなわち、AI開発や統計作成に利用する限り、本人の同意なしに、個人データ、病歴・思想信条などの要配慮個人情報および個人関連情報を事業者や国が取得・利用・第三者提供できるようになります。

政府は、「統計情報やAI学習等は匿名化されるから問題ない」「日本のAI開発を推進するための規制緩和である」等と説明しました。しかしこの統計特例は本当に問題がないのでしょうか。「統計特例」の本当の危うさは、「自分の要配慮個人情報や個人データ等がどう利用されるか」という自分だけの自己決定の問題にとどまらないところにあります。

2.統計特例の「ねじれ」
統計特例における情報のAIによる取扱いを分解すると、つぎのようになります。
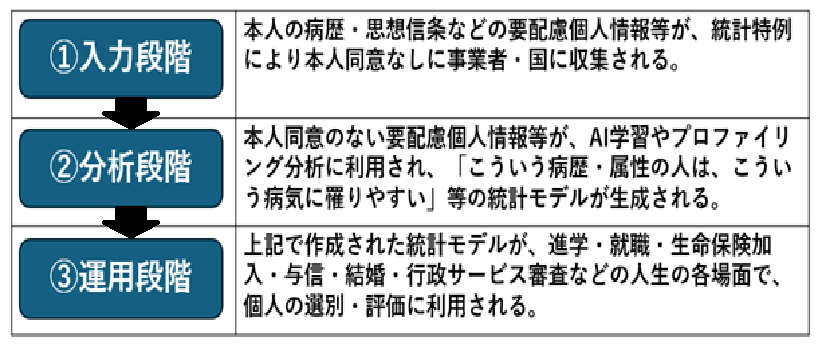
AIモデルの図

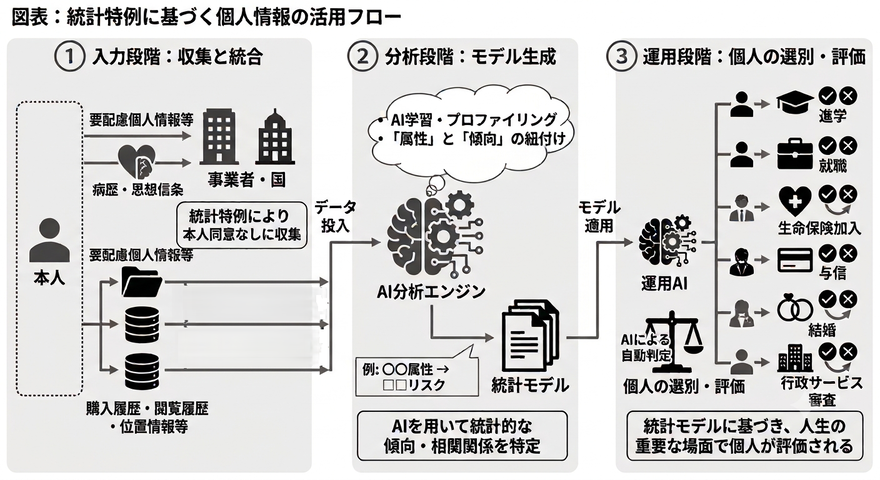
すなわち、まず、①入力段階では、本人の病歴・思想信条などの要配慮個人情報等が、統計特例により本人同意なしに事業者・国に収集されます。つぎに、②分析段階では、本人同意のない要配慮個人情報等が、AI学習やAIプロファイリング分析に利用され、「こういう病歴・属性の人は、こういう病気に罹りやすい」「こういう属性の人は、こういう思想信条を持っている」等の統計モデルが生成されます。さらに③運用段階では、上記で作成された統計モデルが、進学・就職・生命保険加入・与信・結婚・行政サービス審査などの人生の重要な各場面で、個人の選別・評価に利用されることになります。

統計特例の図

この①から③までの流れのなかに、「ねじれ」の問題があります。つまり、③の運用段階でAIに選別・評価される「本人」は、①の入力段階で情報を取得された本人と同一人物とは限らないという問題です。

例えば、Aさんの病歴データ等がAIにより統計処理され、「ある属性の集団はある病気に罹患するリスクが高い」という統計的知見(モデル)が生成されたとして、このモデルがAさんとはまったく関係のないBさんの就職活動の採用選考や、婚活のマッチング、生命保険の引受審査などに、Bさんの本人同意なしにそのまま利用されてしまうおそれがあります。

つまり、統計特例がもたらす社会は、「自分のデータをどう使われるか」という自己決定・情報自己決定の問題を超えて、「自分と似た属性を持つ他人の集団のデータから作られた「ものさし」によって、自分が同意なしに、一方的にAIに分類・選別されるディストピアのような社会となるのです。

3.プロファイリング・セグメント主義(新集団主義)
この問題は、憲法学・情報法学の山本龍彦教授のプロファイリングやセグメント主義(新集団主義)の議論とも合致するものです。

すなわちAI社会においては、自分が開示していない病歴や思想信条などの情報が、自分自身のデータではなく、他人の集団(セグメント)的なデータにより形成されるモデルにより「推知」(類推)され、それに基づいて自分本人へのさまざまな決定・処理、選別・差別が行われるおそれがあるのです(山本龍彦『AIと憲法』67頁)。

政府は国会で「「統計情報やAI学習等は匿名化されるから問題ない」と説明してきましたが、この説明はこの「ねじれ」の問題をまったく解消していません。むしろ個人が特定されないからこそ、国民本人は、いつどのモデルによって、どんな「ものさし」で選別・差別されるのかを知ることもできないまま、進学・就職・結婚・与信・生命保険加入などの人生の重要なそれぞれの場面で選別・差別され続けることになります。

(2019年には、人材紹介会社が本人同意なしに就活生のネット閲覧履歴などから「内定辞退率予測データ」を作成し企業に販売していたリクナビ事件が大きな社会問題となりました。)

4.自己情報コントロール権・情報自己決定権からの反論
この「ねじれ」の問題は、憲法学・情報法学で長年議論されてきている「自己情報コントロール権」からも問題です。

憲法13条は、「すべて国民は、個人として尊重される。生命、自由及び幸福追求に対する国民の権利については、公共の福祉に反しない限り、立法その他の国政の上で、最大の尊重を必要とする。」と規定しています。

この「個人の尊重」と「幸福追求に対する国民の権利」(幸福追求権)に基づいて、個人情報が公権力や大企業等により集中的に管理されている現代社会においては、個人が個人情報を自らコントロールし、自己の情報について開示・訂正・削除請求、利用停止請求などの権利行使が認められるべきであるとする権利と自己情報コントロール権は理解されています(渡辺康行・宍戸常寿・松本和彦・工藤達朗『憲法Ⅰ基本権 第2版』125頁、芦部信喜・高橋和之『憲法 第8版』127頁)。

しかし今回の改正個人情報保護法で導入された統計特例では、個人情報の利用・第三者提供などの各場面の大原則である「本人の同意」という手続きが廃止されます。つまり、統計特例は、国民個人の自己の情報に関する決定権を丸ごと事業者や国に譲り渡すものです。

例えるならば、私たちの思想信条や病歴などのデリケートなデータ、行動履歴・購買履歴・位置情報など個人データは、この国の主権者としての国民個人の「私」のものではなく、IT事業者や国のAIモデルを太らせ成長させるための「餌」となり、私たち国民個人はAIモデルに餌を供給するための「家畜」になるのです。

(なお近年、憲法学・情報法学の曽我部真裕教授などから自己情報コントロール権説を批判する形で、「自己の情報を適切に取扱われる権利説」が有力に主張されています。すなわち同説は、情報プライバシーにおいては本人の同意や自己決定は本質的な要素ではなく、むしろ自己の情報がプラットフォーム事業者などの事業者に適切に取扱われることが重要であると主張します(曽我部真裕「自己情報コントロール権は基本権か?」憲法研究3号71頁)。しかし、本人同意は本質的な問題ではないとする同説に立つと、上記であげた統計特例の「ねじれ」の問題をうまく批判できないように思われます。)

5.統計特例賛成派からの反論への再反論
(1)AI開発の国際競争
上記のような統計特例反対論に対しては、統計賛成派からは、「AI開発の国際競争のためにはやむを得ない。EUなども同様のはずだ。」との反論があるかもしれません。

しかし、EUのGDPR(一般データ保護規則)が認めているのは、あくまでも「再識別のリスクを可能な限り低減するレベルまで匿名化した後」のデータの利用であり、匿名化・統計化された結果を使えるという仕組みです。一方日本の統計特例は、要配慮個人情報を含む「生データ」そのものを事業者が本人同意なしに取得・利用・第三者提供を認める仕組みです。

つまりEUは、匿名化した情報のやり取り等を自由にするのに対して、日本は匿名化などをする前の生データが事業者間を転々と流通することを許容してしまうのです。「AI開発の国際競争」の重要性は当然ではありますが、その運用の前提となる仕組みが日本の統計特例はあまりにも国民個人の権利利益や人格権、プライバシー権、内心の自由などの基本的人権を軽視しています(個情法1条、3条、憲法13条、19条)。

(2)事業者に対する公表義務や委託先の監督などの法的義務
また、統計特例賛成派は、改正個人情報保護法に定められた事業者に対する公表義務や、委託先の監督などの法的義務で上記のような問題は回避できると主張するかもしれません。

しかし、事業者の公表義務や委託先への監督などの安全管理措置などは現行法でもすでに存在します。しかしそのような仕組みをもってしても、名簿業者の問題や、委託先経由の情報漏えいの大規模な事故は後を絶ちません。今回の改正法で盛り込まれた公表義務や、委託先の監督なども、現行法と同様に形式的なものに留まります。課徴金制度も導入されましたが、その対象となる事象は限定的なものに留まっています。

6.まとめ
統計特例に「個人を特定しない」という建前があるとしても、要配慮個人情報等が生データの形で本人同意なしに社会を流通する以上、それらの情報による名寄せや再識別のリスクは依然として残ります。データによる差別(統計的差別)やプロファイリングの危険も存在します。「AI開発の国際競争のため」という大義名分のために、私たち国民個人は、自らの情報に対する主権・自己決定権・統治権を手放そうとしているのではないでしょうか。このような法改正は、この国の主権者のはずの国民の、「個人の尊重」や幸福追求権を大きく侵害するものなのではないでしょうか。

■このブログ記事に興味・関心を持たれた方は、SNSやはてなブックマーク等でシェアしていただけると嬉しいです!

■関連するブログ記事
・あなたの病歴が外国企業に渡る?-「統計特例」に関する個人情報保護法改正案の問題点
・あなたのLINEの情報が保険営業に?ー2026年個人情報保護法改正の「AI学習目的」という抜け穴
・個情委の「3年ごと見直し」における医療データの取扱いに本人同意を不要とする議論に反対する
・政府の検討会議で健康・医療データについて患者の本人同意なしに二次利用を認める方向で検討がなされていることに反対する

■参考文献
・「個人情報の保護に関する法律等の一部を改正する法律案」の閣議決定について|個人情報保護委員会
・野呂悠登「令和8年改正個人情報保護法はどうなる?改正法を弁護士が解説」businesslawyers
・「個人情報保護法いわゆる3年ごと見直しの改正法案についての意見書」|日弁連
・山本龍彦『AIと憲法』67頁
・曽我部真裕「自己情報コントロール権は基本権か?」憲法研究3号71頁
・渡辺康行・宍戸常寿・松本和彦・工藤達朗『憲法Ⅰ基本権 第2版』125頁
・芦部信喜・高橋和之『憲法 第8版』127頁

人気ブログランキング

ブログランキング・にほんブログ村へ

このエントリーをはてなブックマークに追加 mixiチェック

AIのイメージ
内閣府 科学技術・イノベーション推進事務局 人工知能政策推進室が、「人工知能基本計画(素案)に関する御意見の募集について」とのパブコメを実施しています(締切6月23日)。

・人工知能基本計画(素案)に関する御意見の募集について|e-GOVパブリック・コメント

「人工知能基本計画(素案)」ですが、ざっと読んだ感じでは、国民個人の権利利益の保護よりも、ますますAIの利活用を推進しようという、いかにも経済界・政官が喜びそうな内容でした。

とりいそぎ、入力フォームからごく簡単な意見を送ってみました。先日のブログ記事でも取り上げた、AIに関する個人情報改正法案の統計利用特例についても書きました。

ところでこのパブコメ、開始が6月19日19時30分で、締切が6月23日23時59分とたった約5日間しかパブコメ期間がないのは、ちょっとあまりにも「広く一般の意見を求める」(行政手続法39条1項)というパブコメの趣旨に反しているのではないでしょうか・・・。政府のAI政策は、あまりにも一般国民のほうを向いていないように思われます。

私の意見はつぎのとおりです。

・クロード・ミュトスなどのようなAIの危険性が増加していることから、日本のAI推進法を抜本的に改め、EUのAI法のようにリスクベースでAIを規制する法律に改正すべきである。

・「法律による行政の原則」の観点からは、AI規制については、AI事業者ガイドラインなどのようにソフトロー中心で規制をおよぼす建付けを抜本的に改め、法律によるハードローにより規制をおよぼすことにより、国民の基本的人権をしっかりと保護する方向に政府の方針を改正すべきである。

・AI規制にあたっては、個人の尊厳、プライバシー権、内心の自由・精神活動の自由などの基本的人権、民主主義などを保護するため、AIを利用した個人のプロファイリングや、AIを利用した個人の内心や精神活動への介入・働きかけを法規制すべきである(個情法1条、3条、憲法13条、19条)。

・現在国会で審議中の個人情報保護法改正案については、AIの開発のための統計利用特例のために本人同意なく要配慮個人情報の収集・利用・第三者提供を可能とする改正の部分について、個人の人格権、個人の尊厳、プライバシー権、内心の自由、自己情報コントロール権、「自己の情報を適切に取扱われる権利」などの個人の権利利益を大きく侵害するものであり違法・違憲なものであるから(個情法1条、3条、憲法13条、19条)、これを撤回すべきである。
■関連するブログ記事
・あなたの病歴が外国企業に渡る?-「統計特例」に関する個人情報保護法改正案の問題点
・あなたのLINEの情報が保険営業に?ー2026年個人情報保護法改正の「AI学習目的」という抜け穴

人気ブログランキング

ブログランキング・にほんブログ村へ

このエントリーをはてなブックマークに追加 mixiチェック

長妻昭氏
(長妻昭氏のYouTubeより)

はじめに
2026年の通常国会に提出された個人情報保護法改正案は、AI活用の推進と個人情報保護の強化を両立させると説明されています。しかし、その目玉である「統計作成等特例」(以下「統計特例」)には、一般にはあまり知られていない重大な問題が含まれています。

本ブログ記事は、2026年6月4日の衆議院予算委員会における長妻昭議員と松本デジタル大臣との質疑応答を出発点に、統計特例のさまざまな法的問題点を検討したいと思います。

1.国会審議において長妻議員が質問したこと
(1)統計特例の仕組みと問題の所在
改正案の統計特例とは、AI開発や統計作成などの目的(「統計作成等」)であれば、本人の同意なしに、氏名・住所が紐づいた生の要配慮個人情報(病歴、思想信条、犯罪歴など)を民間企業に提供できるとする制度です。

長妻議員が最初に指摘したのは、この「統計目的だから安全」という論拠の弱さです。政府の説明する「個人の権利利益を害するおそれが少ない」という根拠は、アウトプットが純粋な集計値である場合には一定の説得力を持ちます。しかし統計処理に入る前の段階、すなわち実名・住所付きの生データが第三者企業の手に渡る瞬間においては、リスクはすでに発生しています。「処理後に安全」と「渡した時点から安全」は、まったく異なる問題だからです。

(2)松本デジタル大臣の答弁とその限界
松本デジタル大臣は、統計特例について、①提供先に安全管理措置と不要データの速やかな削除を義務付けること、②公表義務・書面合意・目的外利用禁止という歯止め措置を設けること、③違反した場合には課徴金の対象となること、を根拠に「利活用と保護のバランスは取れている」と主張しました。

しかしこれらは、いずれも「違反がまず発覚すること」を前提とする事後的制裁です。取得された要配慮個人情報の生データを受け取った企業が内部でどう使ったかを外部から検知す法的手段は存在しません。

また、本人が「自分のデータを提供しないでほしい」と申し出る権利(提供停止請求権)については、「適法な処理である限り、無条件の停止請求には応じられない」という松本大臣の答弁が示されました。これは、情報自己決定権の実質的な否定に等しいと評さざるをえません。

(3)拒否権の欠如-憲法学・情報学からの検討
憲法13条のプライバシー権については、山本龍彦先生が自己情報コントロール権説を継承しつつ、AI・ビッグデータ時代に対応させた形で精緻化しています。山本説の特徴は、権利論と審査論を接合している点にあります。権利の実体面では、プロファイリング・スコアリングなどAI固有のリスクに対応した権利内容の拡張を論じ、審査の手法面では、情報の収集・管理・利用・連携の各段階をシステムの設計・構造全体から総合的に判断する「構造審査」を採用しています。

山本説からは、統計特例はまずはダイレクトに「本人同意なし」とされたことが批判の対象になるでしょう。

他方、曽我部真裕先生は、プライバシー権を「自己の情報を適切に取り扱われる権利」として再構成すべきとする有力説を提唱しています。「コントロール」という概念が本人の同意・意思を中心に置きすぎており、情報取扱いの文脈適合性という観点が抜け落ちるという批判がその核心です。

曽我部説からは、病歴情報が医療という文脈で提供されたにもかかわらず、AI学習・プロファイリングという全く異なる文脈で利用されることが「適切な取扱い」からの逸脱として捉えられます。

この点判例は、自己情報コントロール権を明示的には採用していません。住基ネット訴訟(最大判平成20年3月6日)は、①収集情報が氏名・住所・生年月日・性別の4情報(基本4情報)に限定されていること、②アクセス主体が行政機関に限定されていること、③システムに厳格な安全管理措置が講じられていること、④第三者機関の存在など法的な歯止めの存在、などを総合考慮して合憲と判断しました。マイナンバー訴訟(最判令和5年3月9日)もこの構造審査の枠組みを踏襲しています。

この構造審査を今回の統計特例に当てはめてみると、住基ネット合憲の根拠がそのまま問題点として現れます。すなわち、①収集情報は病歴・障害・思想信条等という最高度のセンシティブな情報であり、②提供先は民間企業に無制限に開放され、内部利用の監視手段がなく目的外利用の発覚は困難です。③④についてもゆるゆるな状態です。

このように、学説・判例のいずれの枠組みによっても、統計特例が憲法13条から導き出されるプライバシー権に抵触する可能性は否定できません。

この点、EUのGDPR(一般データ保護規則)では「自動化された意思決定に服しない権利」(22条)や「処理に対する異議申し立て権」(21条)が明文で保障されています。今回の改正案にはこれらの視点が抜け落ちています。

(4)「仮名加工した上でデータを活用」との長妻議員の提案
長妻議員は、医療データの活用自体には賛成しつつ、実名・住所のまま提供する必然性はないとして、「次世代医療基盤法」方式、すなわち仮名加工した上でデータを活用することへの法案修正を求めました。

製薬業界も研究目的には実名情報は不要と述べており、日弁連・医師会・消費者団体も危険性を指摘しています。仮名化によって個人データの利用は十分可能です。この修正要求は、政策論として合理性があるのではないでしょうか。

2.各論点の深掘り-統計特例の諸問題
(1)「統計目的と言いながら別目的に使う」リスク
改正案は、「企業が統計利用目的を守る」という性善説に全面的に依存しています。しかし、実名・住所付きデータを受け取った企業が内部でプロファイリングやスコアリングに転用しても、外部からは発見することができません。

2019年に発覚したリクルートによる就活生の内定辞退予測データ販売事件(リクナビ事件)は、プロファイリングやスコアリングの問題点を如実に示しています。同事案では、企業が採用活動の文脈で収集した個人データを、本人の同意なく内定辞退率のスコアとして企業に販売していました。今回の改正は、そのような機微な個人情報の転用の入口をさらに広げてしまうおそれがあります。

(2)「逆照射的プロファイリング」という新たな脅威
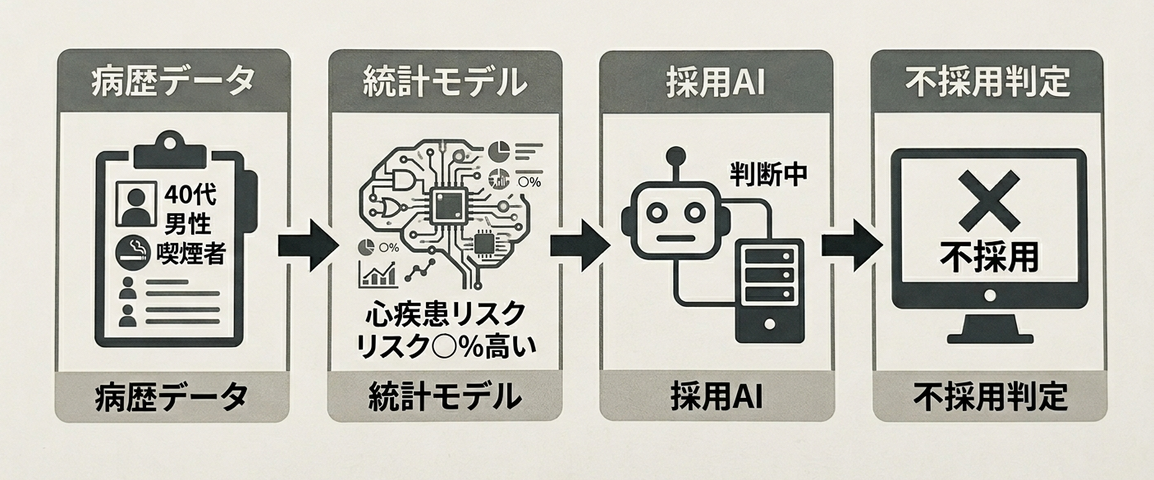
また、「逆照射的プロファイリング」という問題があります。これは、集団の統計情報をAIに学習させることで、特定個人の属性を逆算・推測するという手法です。
【具体例】
病歴データから「40代・男性・喫煙者の心疾患リスクは○%高い」という統計モデルを構築する。次に採用・融資審査AIがこのモデルを参照し、「この応募者は心疾患リスクが高い」と判定して不採用にする。本人には理由が告知されない。
1780764685388

統計処理した時点では、個人情報は統計情報という集合に溶け込んだように見えますが、そのモデルに個人データを当てはめることで、個人への不利益が「復活」してしまいます。

就職・人事考査・融資・保険加入・住宅賃貸等といった生活の根幹に関わる場面で差別が生じるリスクがあります。しかも、本人は被害の事実すら知る手段を持ちません。本人同意なしに統計利用目的で要配慮個人情報の取得・第三者提供を可能にすることは、このような問題を拡大させるおそれがあります。

(3)課徴金の実効性-「ばれなければよい」問題
改正案は課徴金制度を導入しましたが、①「事業者が相当の注意を怠っていない場合」または②「対象の本人が1000人を超えない場合」には課徴金の対象外となるとされています。そのため、大規模な違反などがなければ課徴金は適用されません。

また、そもそも発覚しなければ課徴金は発動しません。企業内部での目的外利用などを常時監視する法的な仕組みは存在せず、課徴金は「ばれた場合の事後的制裁」にすぎません。

そのため、課徴金制度も統計特例における不適切・違法な個人情報の取扱いの歯止めとして十分なものであるかは疑問が残ります。

(4)外国企業への情報流出のリスク
今回の改正案において特に深刻な問題の一つが、外国企業への対応です。統計特例による要配慮個人情報の提供は、現行法上の越境移転規制(法28条)の適用外となるとされており、「統計目的」と称すれば越境移転規制をすり抜けて外国企業に用配慮個人情報が渡ってしまう状況が生じうるとされています。

中国に拠点を持つ企業は中国国家情報法(2017年)上、当局への情報提供協力義務を負っています。「統計目的」として渡した日本人の病歴・障害情報などが、事実上外国政府の情報収集に転用されるリスクが否定できません。

また、日本の個人情報保護委員会が外国企業に課徴金を命じたとしても、相手国における執行手段はほぼ存在しません。これは単なるプライバシー問題を超えて、安全保障上の問題でもあります。

(2021年には、LINEの個人情報について、中国・韓国の委託先企業で不適切な取扱いが行われていることが大きな社会問題となりました。)

(5)国際標準との乖離
長妻議員は上記の国会審議で、「要配慮個人情報を生データのまま民間企業に提供している国は日本だけ」と主張しましたが、これは先進国の主要法制との比較において基本的に正しい指摘です。

EUのGDPRは、統計・研究目的で特別カテゴリデータを処理する場合でも仮名化を原則として明文で要求しています(第89条)。つまり、実名・住所付きの生データを統計目的として民間企業に渡すという発想自体が制度上存在しません。 また、米カリフォルニア州CPRAは、センシティブ情報について本人の「限定利用請求権」を保障しています。

これに対して日本の改正案は、AI学習の入口段階の規制を大幅に緩和する一方、AIの出力段階(プロファイリング・自動意思決定)における保護も著しく不十分という設計であり、国際標準から明確に後退しています。

3.まとめ
統計特例をめぐる議論の本質は、「AI利活用の推進」という政策目標が、個人のプライバシー権や人格権という基本的人権(憲法13条)を不当に犠牲にする形で実現されようとしているのではないか、という疑問に集約されます。

山本説・曽我部説いずれの学説からも、また住基ネット訴訟・マイナンバー訴訟の判例の判断枠組みからも、統計特例は違法・違憲のおそれがあり、その設計には根本的な再検討が求められます。

国会審議においても、仮名化への修正を中心とした実質的な議論が行われることを期待したいと思います。

国民一人ひとりの病歴・障害情報・思想信条などの要配慮個人情報が、本人において自らの関知しないところで取引され、プロファイリングやスコアリングに利用され、場合によっては外国企業・外国政府の手に渡る可能性のある制度設計は、立憲主義的な観点から問い直されなければならないと考えられます。また、中長期的には日本の個人情報保護法もプロファイリングを正面から規制するための検討が行われれるべきであると考えられます。

■関連するブログ記事
AIの餌にされる私たち-改正個人情報保護法の統計特例の問題点
・あなたのLINEの情報が保険営業に?ー2026年個人情報保護法改正の「AI学習目的」という抜け穴
・国家情報会議・国家情報局と2020年ドイツBND法違憲判決-日独の情報機関の統制の比較
・リクルートなどの就活生の内定辞退予測データの販売を個人情報保護法・職安法的に考える
・LINEの個人情報・通信の秘密の中国・韓国への漏洩事故を個人情報保護法・電気通信事業法から考えた

■参考文献
・【高市首相に問う!】 高市首相も知らされず? 名前住所付き病歴情報も本人同意無く統計特例で企業に渡る! 激論!(令和8年6月4日 衆議院予算委員会 ながつま昭質疑)
・野呂悠登「令和8年改正個人情報保護法はどうなる?改正案を弁護士が解説」BUSINESS LAWYEARS
・「個人情報保護法いわゆる3年ごと見直しの改正法案についての意見書」|日弁連
・山本龍彦『超個人主義の逆説-AI社会への憲法的警句』141頁
・曽我部真裕「自己情報コントロール権は基本権か?」憲法研究3号71頁
・宍戸常寿「住基ネットの合憲性」『新・判例ハンドブック情報法』200頁
・個人情報の扱い、変わる? 統計情報「同意なく提供」、差別おそれも 編集委員・若江雅子|朝日新聞

人気ブログランキング

ブログランキング・にほんブログ村へ

このエントリーをはてなブックマークに追加 mixiチェック

LINEロゴ
1.LINEが「子の有無・学歴・職業」等のプロファイリング情報をターゲティング広告に利用していた問題
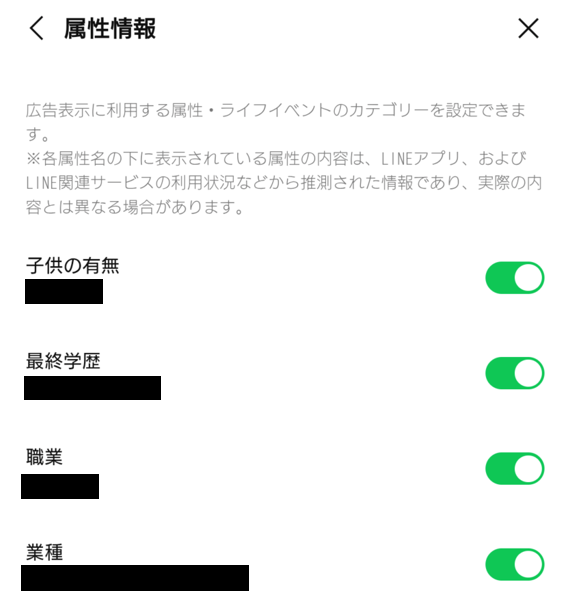
2026年5月28日、ITmedia NEWSは、LINEアプリの広告機能において、ユーザーの子どもの有無・最終学歴・職業等といった機微な個人情報がターゲティング広告に利用されていることが発覚し、SNS上で炎上したと報じました(「子の有無や学歴、年収まで……LINEの広告設定が「怖い」と物議 LINEヤフーに意図を聞いた」ITmedia NEWS)。

私も自分のLINEの属性情報の画面を確認しましたが、設定が「オン」になっているとともに、それぞれの属性情報はほとんどが当たっていました。
LINE属性情報

特に問題とされたのは、当該設定がデフォルトで「オン」になっていた点です。多くのユーザーは自覚のないまま、LINE上あるいはウェブサイト上などの行動履歴、購入履歴、登録情報(年齢・性別・地域等)を組み合わせた形でターゲティング広告に自己の情報を活用されていたことになります。SNS上では「知らないうちにオンになっていた」「友人とのトークを見られているのでは」などの不安の声が多数寄せられたとのことです。

LINEヤフー社は「トークの内容は広告に使っていない」と説明し、2025年8月より設定画面を改善してオプトアウトを可能にしたとしていますが、それ以前の長期間にわたりユーザーへの十分な告知なくこうした取扱いが行われていたことは事実のようです。

2.LINEヤフーの日本生命への「結婚予兆セグメント」販売ビジネス
筆者は2025年1月、LINEヤフー社が保有するユーザーの個人データをプロファイリングし、「結婚予兆セグメント」「転職活動の検討セグメント」といった分類結果を日本生命等のパートナー企業に第三者提供(販売)していることを紹介しました。(なか2656のblog「LINEヤフーが「LINE公式アカウント」の企業に「結婚予兆」等のプロファイリング結果を第三者提供していることを個情法から考えた-プロファイリング結果の第三者提供」2025年1月19日)

日本生命はこのプロファイリング結果を活用し、同社のLINE公式アカウントの「友達」ユーザーのうち、「結婚予兆セグメント」に分類された層に保険を提案したところ、保険契約の成約率がLINEを使わない提案手法に比べ10倍以上になったと報告されたとのことです。また、日本生命は「転職活動の検討セグメント」データも採用活動に利用しており、第一生命・T&Dグループも同様の手法を活用しているとされています。

LINEヤフー社は、同社のプライバシーポリシー上「統計情報」としてパートナー企業への提供を説明しており、現行の個人情報保護法上は一応法的な条件をクリアしていると考えられます。しかし、ユーザー識別符号とセットで提供されている以上、実態は個人データの提供と評価される余地があり、また「結婚予兆」「転職検討」といった情報はLINEヤフー社自身が「機微な属性の推定・分類は行わない」と宣言していることとの矛盾も残ります。

※なお、NTTドコモなども、同様にプロファイリング情報の販売ビジネスを行っているとのことです(ドコモ、1億規模の会員データをプロファイルして広告主に提供へ 「引っ越しそうな人」「EVに興味ある人」など的確に|ITmedia NEWS)。

3.現行個人情報保護法の問題点―プロファイリング規制の欠如
EUのGDPR22条等がプロファイリングについて明確な法規制を設けているのに対し、日本の個人情報保護法はプロファイリング行為そのものを正面から規制していません。

個情法17条1項の「利用目的の特定」義務や同ガイドラインの規定により、事業者はプロファイリングを行う旨をプライバシーポリシー等に記載することが求められるが、実際には包括的なプライバシーポリシーへの同意取得で処理されており、一般ユーザーが自己の情報がどのように分析・販売されているかを正確に把握できているとは言い難い状況です。

また、個情法19条は個人情報の不適正を禁止していますが、同法の条文はあいまいであり、個情法ガイドライン(通則編)の規定や具体例も限定的であり、その実効性が問題となります。

さらに、福岡真之介ほか『AIプロファイリングの法律問題』が指摘するように、プロファイリング結果の第三者提供は、①本人がその内容を把握できないリスク、②提供先での利用目的が予測できないリスク、③プライバシー権侵害のリスク(民法709条・憲法13条)をはらんでおり、通常の個人データの第三者提供とは別次元で論じる必要があります。

こうしたプロファイリングに関する問題意識は個人情報保護委員会の法改正の検討会議などでも議論されたはずですが、2026年法改正ではプロファイリング規制は見送られました。

4.2026年個人情報保護法改正-「AI学習目的」での本人同意不要化
現在、国会で審議中の2026年個人情報保護法改正法案は、「適正なデータ利活用の推進」を掲げ、「個人データ等の第三者提供及び公開されている要配慮個人情報の取得・第三者提供について、統計情報等の作成(統計作成等であると整理できるAI開発等を含む)にのみ利用される場合は本人同意を不要とする」趣旨の改正が盛り込まれています。

注目すべきは「統計作成等であると整理できるAI開発等を含む」という点です。民間企業が行うAI開発・機械学習が広く対象になるとされています。つまり、要配慮個人情報であっても、「AI学習目的」であれば本人同意なしに取得や第三者提供が可能となります。

5.「AI学習目的」という抜け穴―法改正の深刻な問題点
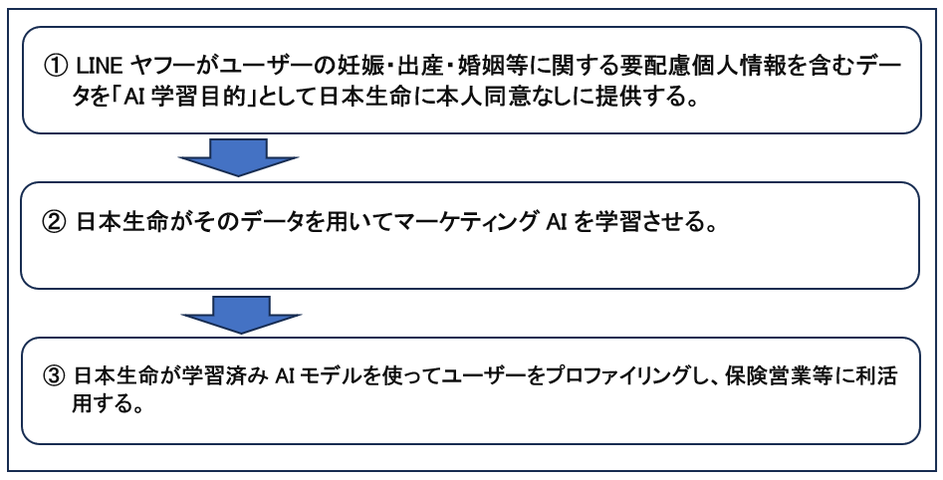
この改正が現実のビジネスに与える影響を、前述のLINEヤフーと日本生命の事例に即して考えてみると、以下のようなスキームが法的に合法として成立することになります。

LINE日本生命の図

改正法は上述の「要配慮個人情報の取得・第三者提供について、統計情報等の作成にのみ利用される場合は本人同意を不要とする」改正について、「統計情報等の作成にのみ利用される場合」という限定を付しており、AI学習目的で取得したデータを直接営業に転用することは禁止されるべきではないでしょうか。しかしそのように考えるには問題があります。

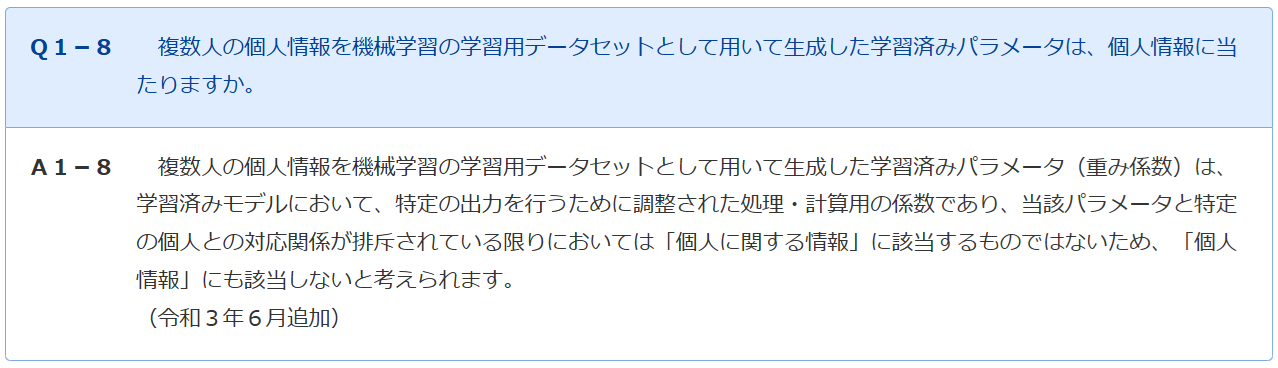
最大の問題は、個人情報保護法上、「学習済みAIモデル」は原則、個人情報でないので法の規制対象ではないとされている点です(個情法ガイドラインQA1-8)。
個情法ガイドラインQA1-8

すなわち、事業者は、個人データそのものは「AI学習」にしか使っていないと整理しつつ、学習済みモデルはその後個情法に縛られずに自由に利用できるのです。学習済みモデルをマーケティングや営業ターゲティングに使うことは、現行個情法上も改正法上も個情法の規制が直接及ばない領域なのです。

一般ユーザーから見れば、普通にLINEを利用して妊娠・出産等の情報がLINEに収集され、本人同意なくAI学習目的で日本生命に提供され、日本生命がそのAIをもとに個人に保険営業を行うという一連の流れが、改正個情法の下でより合法的に成立しうることになります。しかしこれは、要配慮個人情報の保護を事実上形骸化させるものと言わざるを得ないのではないでしょうか。

※なお、LINEの事例にある「子どもの有無」「結婚予兆」などは、個情法上の要配慮個人情報(病歴、思想信条、犯罪歴など)には厳密には該当しませんが、しかし個人のプライバシーの核心に直結する非常に機微な情報です。個情法の法改正の議論がこのまま進めば、こうした機微な情報のAIによる利活用がさらに肯定されかねないという点で、問題の本質は地続きです。

6.まとめ
今回の2026年個情法改正は、AI推進・データ利活用という経済政策的要請を優先するあまり、要配慮個人情報の保護を実質的に後退させるリスクを内包しています。個人情報保護委員会は、個情法施行令・施行規則やガイドライン等において、少なくとも以下の点を明確にすべきではないでしょうか。

●「AI学習目的で取得したデータから生成したモデルを営業・マーケティング・スコアリング目的等に転用することは不適正利用(個情法19条)に当たる」旨を個情法ガイドライン・同QA等に明記し、歯止めをかける。

●「統計情報等の作成にのみ利用」の要件を形式的・技術的な解釈で潜脱できないよう、利用目的・利用態様の実態に即した厳格な運用基準を設ける。

●中長期的にはEUのGDPRやAI法のように、日本の個情法もプロファイリング規制を設け、AIによる自動意思決定を法律レベルで規制する制度の導入を検討する。
LINEのような国民的インフラを活用した大規模プロファイリング情報販売ビジネスは、今後AIの普及とともにさらに高度化・拡大していくことが予想されます。個人の権利利益の保護や人格尊重(個情法1条、3条、憲法13条)という法の基本理念が形骸化しないよう、国会・行政レベルでの対応が求められるものと思われます。

■関連するブログ記事
・あなたの病歴が外国企業に渡る?-「統計特例」に関する個人情報保護法改正の問題点
・「LINEヤフーが「LINE公式アカウント」の企業に「結婚予兆」等のプロファイリング結果を第三者提供していることを個情法から考えた-プロファイリング結果の第三者提供」なか2656のblog
・あなたの人事異動をAIが決める日—富士通のAI人事システムと日本の法的空白|なか2656のblog

■参考文献
「子の有無や学歴、年収まで……LINEの広告設定が「怖い」と物議 LINEヤフーに意図を聞いた」ITmedia NEWS
・保険の成約率10倍以上に…日本生命、顧客開拓にLINE活用|ニュースイッチ
・ドコモ、1億規模の会員データをプロファイルして広告主に提供へ 「引っ越しそうな人」「EVに興味ある人」など的確に|ITmedia NEWS
・個情法改正へ 本人同意なしの統計作成とAI開発、リスク検討十分か|朝日新聞
・岡村久道『個人情報保護法 第4版』208頁
・福岡真之介・杉浦健二・田中浩之・坂田晃祐ほか『AIプロファイリングの法律問題』42頁、353頁

人気ブログランキング

ブログランキング・にほんブログ村へ

このエントリーをはてなブックマークに追加 mixiチェック

↑このページのトップヘ